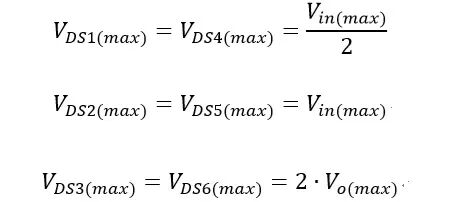No data
写文章
发视频
提问题
传文档
电子设计讲堂 专家精讲课程 知识传授指导
前沿电子资讯 电子技术干货 经验知识总结
设计问答汇总 在线答疑解惑 达人倾囊相授
专业行业文档 知识类目清晰 要点一键下载
阻抗计算神器 多层板阻抗 凡亿层压结构
PCB设计指南 EDA设计指南 封装设计指南
Symbol下载 PCB封装下载 3D模型下载
快速打孔设置 器件快速聚拢 一键检查跨分割
凡亿ADSkill工具 敷铜脚本插件 快速添加差分
技术题库汇总 如何谈薪资 常见面试技巧
优质电子公司 专业人才简历 高薪一键触达
凡亿教育是凡亿旗下专注于电子工程师人才培养与工程实践教育的专业品牌,致力于打造“电子工程师梦工厂”,构建以工程实践能力和就业发展为导向的电子设计人才培养平台。依托凡亿集团在电子产品研发、硬件设计、PCB设计、信号完整性分析、PCB制造及电子产业服务等领域长期积累的产业经验,凡亿教育将企业真实研发流程、工程标准和项目经验融入人才培养体系,帮助学习者从知识学习走向工程实践。
2025年8月22号,Nature Communications发了一篇论文。论文的第一作者是IBM Almaden实验室的一个研究员。IBM Tokyo、IBM Yorktown、还有IBM Albany的一个纳米技术中心,联合起来干了一件事。他们在一片14纳米的芯片上,用相变存储器跑了710万个
故事要从2018年说起。那年10月,华为在全联接大会上第一次公开了昇腾310和昇腾910。当时公布的指标确实吓人:FP16算力256 TFLOPS,INT8算力512 TOPS,最大功耗310W。图1 昇腾产品与系统演进主线2019年8月23号,910正式发布,MindSpore同天推出。但我觉得比
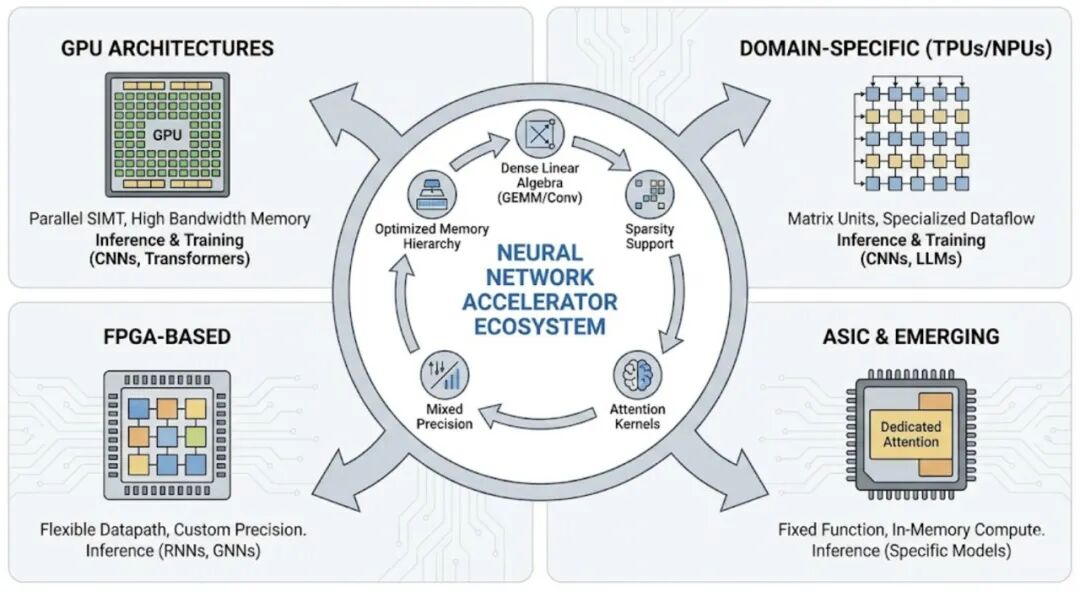
为什么AI需要专门的硬件加速?聊AI芯片之前,先想明白一个问题:为什么CPU跑AI这么慢?本质上,神经网络计算就是海量的矩阵乘法和卷积运算。这些运算的特点是计算密度高、并行性强,但控制逻辑简单。CPU设计目标是通用计算,强大的控制单元和缓存层次用来处理复杂的分支和随机内存访问,但拿来跑矩阵乘法就像用
我是老温,一名热爱学习的嵌入式工程师关注我,一起变得更加优秀!最近,我在折腾各种AI Agent从2026年3月到现在,短短一个季度的时间,不知道各位嵌入式老铁有没有留意到一个现象,就是,各个大厂(腾讯、阿里、字节、月之暗面、网易、智谱)都在推出自家的桌面级 AI Agent。我让元宝帮我搜集和统计
最近圈子里的朋友都在聊一件事:AI服务器PCB设计工程师太缺了。据行业数据,2026年全球AI服务器出货量预计突破200万台,同比大增110%。英伟达新一代VR200机柜的PCB价值量直接暴涨233%,从3.51万美元跳到11.67万美元。
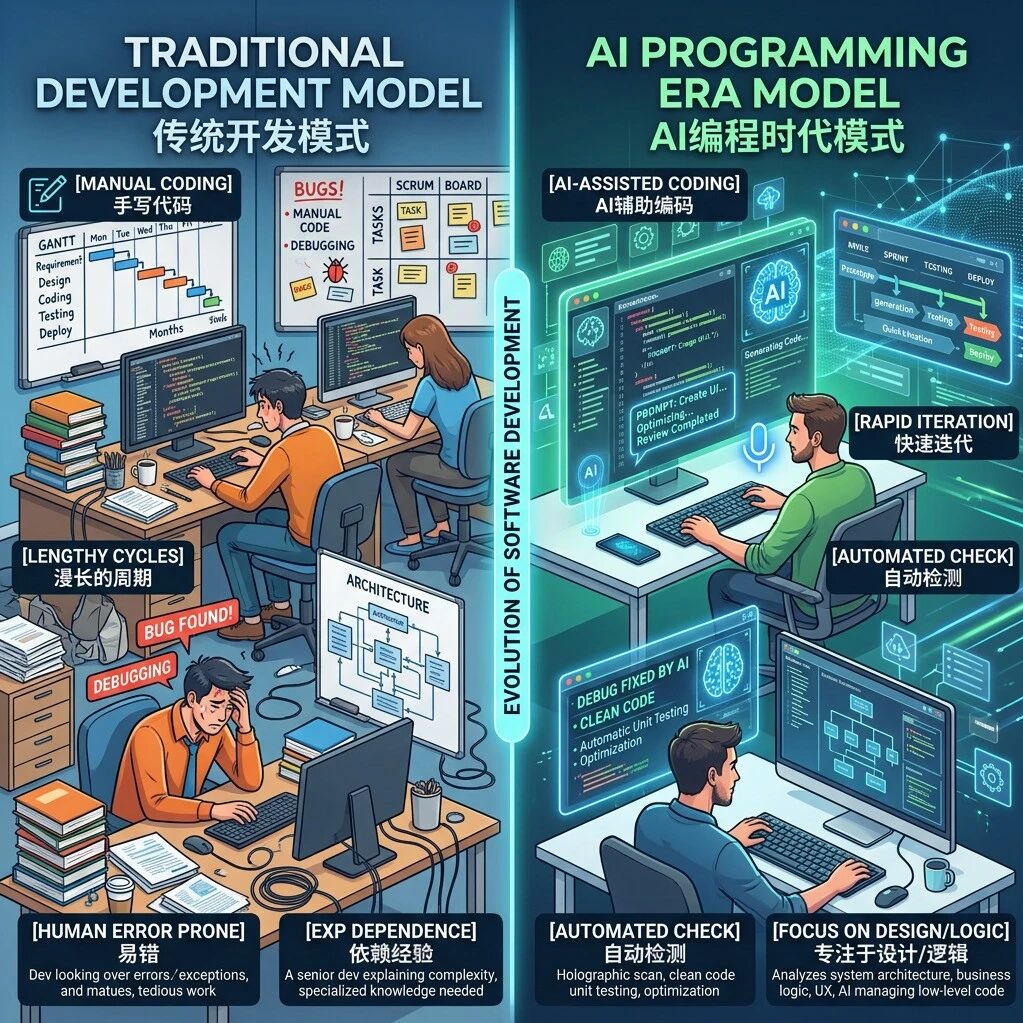
导语:AI编程正在进入新阶段。过去我们关注的是“AI能不能写代码”,现在真正拉开差距的是:能不能让AI生成更高质量、更可靠、更可控的代码,并且尽可能节约token、减少无效消耗。本文系统梳理了新一代AI编程的关键技术:上下文工程、任务协议式Prompt、分步生成、验证链路、可控生成和Token优化。
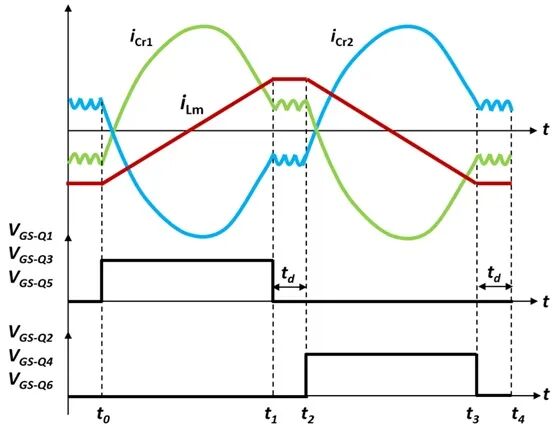
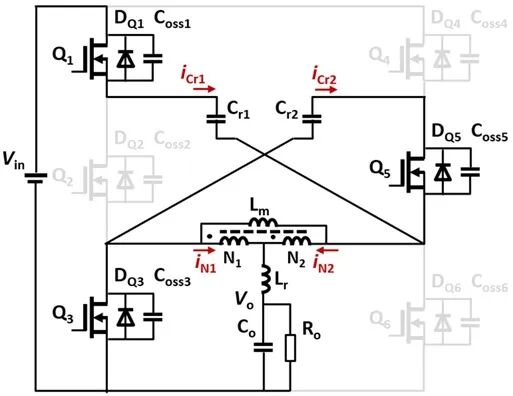
1、耦合电感HSC的波形每个开关周期,工作占空比D=0.5,两组开关管Q1、Q3、Q5和Q2、Q4、Q6交替开关工作,相位相差180度,输入电源对其中一个飞跨电容充电向输出负载传输能量,另一个飞跨电容放电实现电荷平衡,开关管工作在零电压ZVS软开关状态,耦合电感HSC变换器工作波形,如图1所示。图1
2026年4月21日,OpenAI正式发布ChatGPT Images 2.0(也就是大家热议的GPT-Image-2),这一消息在科技圈炸开了锅。更劲爆的是,DALL-E 2和DALL-E 3将于2026年5月12日彻底停止服务——这意味
无压纳米烧结银:AI加速器市场的隐形基石无压纳米烧结银正成为AI加速器中GPU/TPU/NPU的核心封装材料,以高导热、低温无压、高可靠、低成本四大优势,破解高算力下的散热、互连与成本瓶颈,直接驱动AI算力密度、能效与良率的跨越式提升。一
大语言模型正在重塑软件开发的日常。从Copilot到各种编程助手,AI生成代码的能力已经渗透到许多开发者的工作流中。但在实际应用中,一个现象值得注意:不少团队在使用AI编程时,陷入了“需求描述-代码生成-发现问题-修改需求”的循环,原本期望
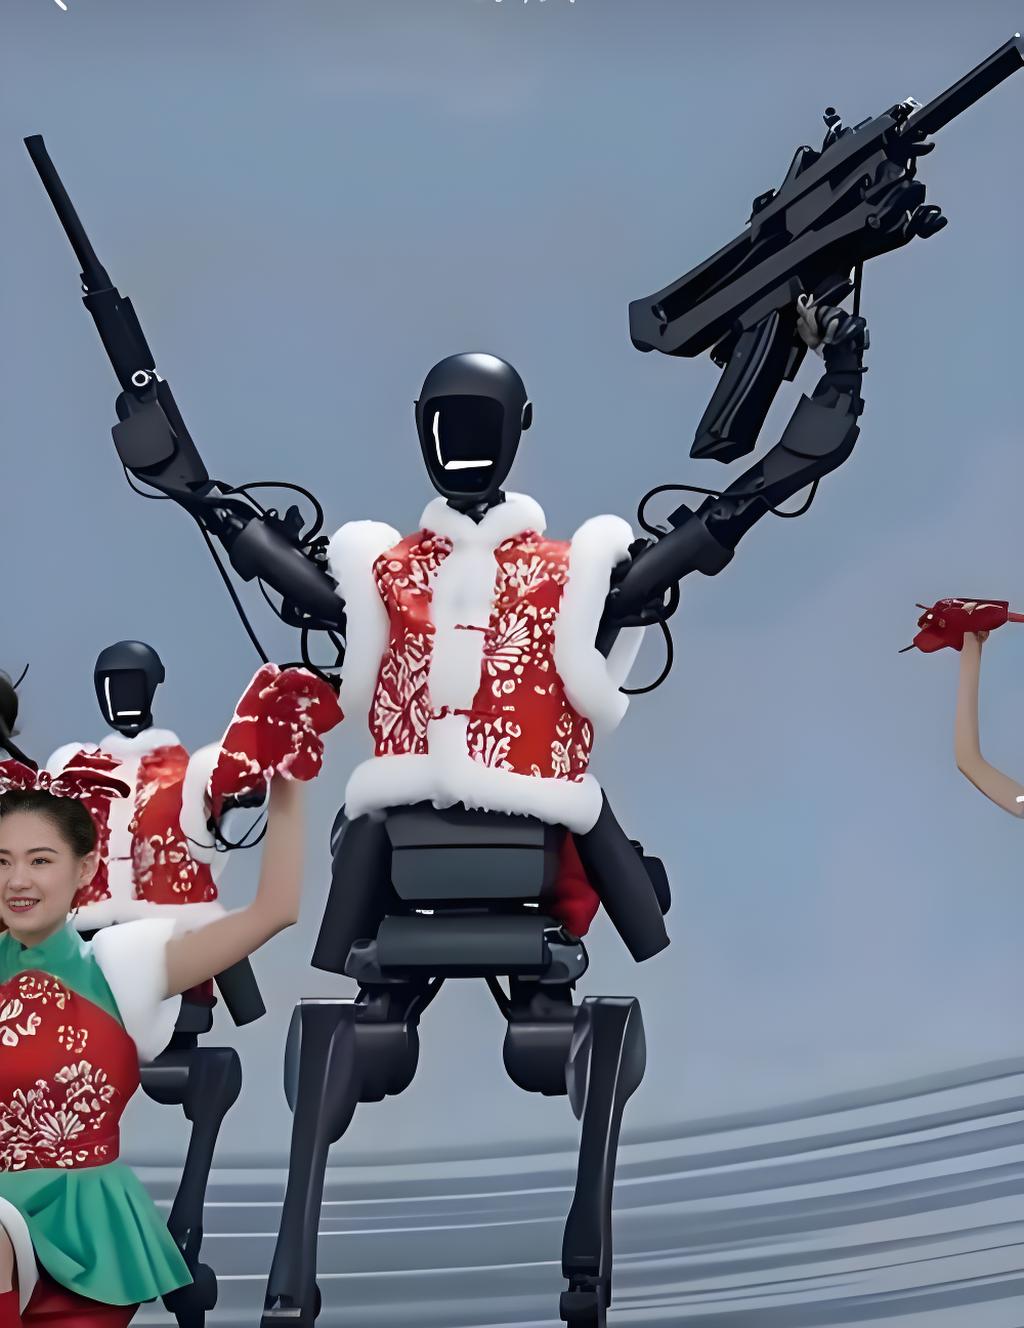
再谈低温烧结银的应用:从春晚四家机器人出镜的幕后推手说起2026年马年春晚四家机器人公司:宇树、魔法原子、银河通用、松延动力的高动态、高精度、高可靠表现,背后离不开低温烧结银在电机驱动、传感器、芯片封装、功率模块的关键支撑;而低温烧结银正从
烧结银膏在CPO/LPO/NPO封装中的应用解析 一、CPO共封装光学封装:高集成度下的热管理与信号可靠性 CPO(Co-Packaged Optics)作为光电共封装技术的终极形态,将光引擎与计算芯片(如GPU、ASIC)或交换芯片共同封
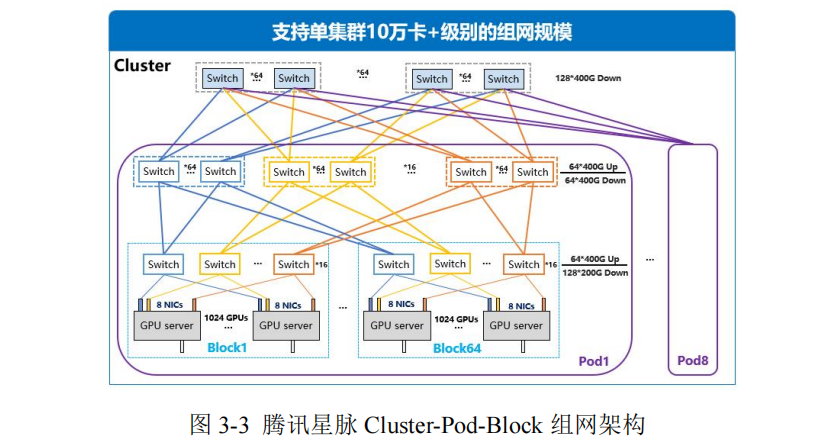
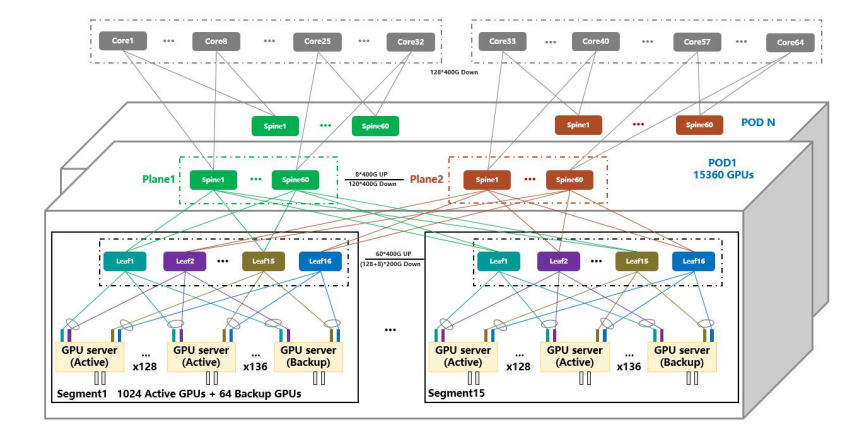
在AI 大模型训练场景中,GPU 数量与模型训练时长通常呈正比关系。多卡训练可极大缩短训练时间,尤其对于千亿级甚至万亿级参数规模的大语言模型,智算集群需支持万卡及以上的并行能力。智算集群内网络架构的优劣对 GPU 服务器内外的集合通信存在极大影响。因此,设计大规模、高可靠、低成本、易运维的优质网络架
数据中心4件套(存储、网络、SSD、服务器)全解系列PPT和PDF姊妹篇已全部发布,更新预告:AI 超节点基础知识全解(精编版)。请通过“架构师技术全店资料打包汇总(全)”获取(之前购买过的读者,从打包链接或微店留言免费获取)。——以下正文——本文内容来自“老张 IT 智习社”,本文围绕算力、AI
发文章
如何制作一个自动刷视频电路?
Xilinx_ISE版 FPGA数字信号处理-FIR核轻松写意完成滤波器设计
电子设计:电源模块的使用
PCB设计基础学习--PCB设计准则第一、二部分
老九零基础学编程系列之C语言课程
电子设计:基于51单片机的心率计的设计与制作(Proteus仿真部分)
2026-07-27 18:02
2026-07-02 16:03
2026-05-20 11:34
2025-06-26 09:58
2023-08-21 16:30:02
2023-08-26 13:52:07
2023-08-26 13:52:41
2023-08-26 13:52:59
2023-08-27 22:52:59
2023-08-30 15:55:42
2026-03-12 16:21:58
2026-10-07 20:47:47
2026-10-07 20:47:33
2026-10-07 20:47:14
2026-10-07 20:47:00
2026-10-07 20:46:47
我要投稿
技术文章
视频教程
百问百答
下载APP
在线客服

 扫码关注