 扫码关注



跨团队问题闭环
一个真实的协作场景:新样机在某个工况下复位,硬件、PCB、固件都能提出看似合理的解释,却没有人能给出证据。面试官更希望听到你如何设计排查顺序、推动验证和管理风险,而不是简单说“我会加强沟通”。
先统一故障定义,再谈责任
第一步不是把人叫到会议室“分锅”,而是冻结可复现条件:硬件版本、PCB版次、软件commit、输入电压、温度、外设连接方式、触发步骤及复位日志。若不能稳定复现,先把触发率和发生前后的信号记录起来。
把猜测变成可验证假设
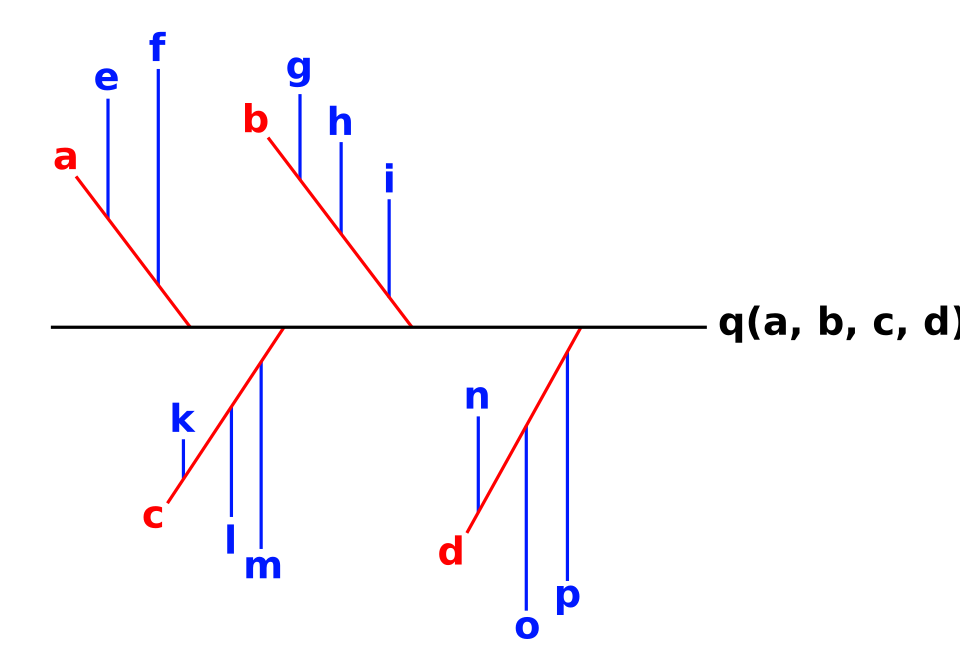
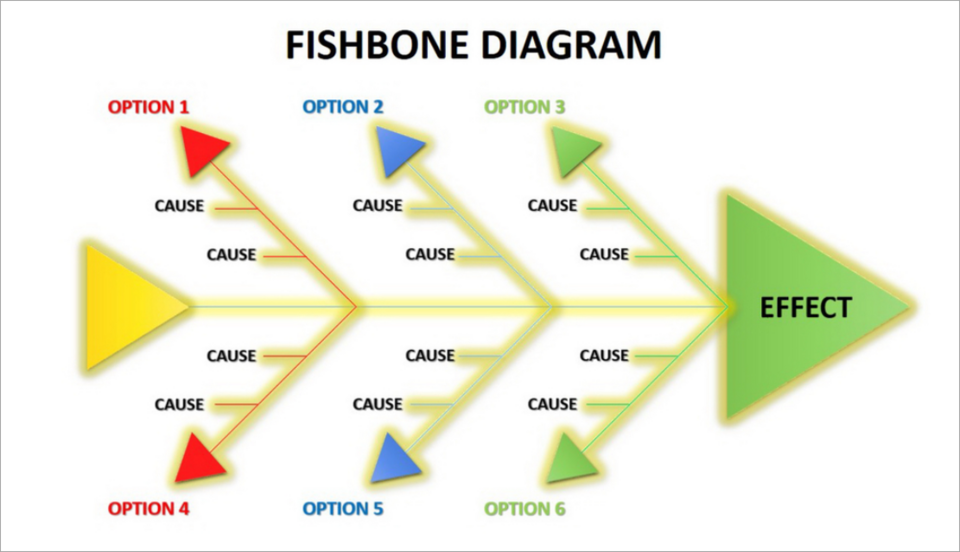
参考鱼骨图思路,将潜在因素按电源、器件、布局布线、软件时序、测试环境、操作流程等分组。每个假设都要有人负责、对应一个低成本实验、规定预期观察值。
例如“电源跌落引起复位”应测复位引脚、电源轨和故障前负载瞬变;“软件卡死”需对照看门狗复位原因、任务日志和堆栈;“布局串扰”则要定位受扰节点、走线关系与示波波形。
避免两类管理性错误
只凭相关性定责任。某个模块换掉后不再复位,只证明故障和该变化相关,不能自动证明原模块就是唯一根因。
只解决复现样机。整改还应确认批次波动、温度角落、供电边界和变更副作用。最终输出实验记录、结论、风险评估、ECN/版本更新及回归验证结果。
回答模板:有动作,有边界
“我先建立复现基线,组织团队列出可验证假设并划分测试负责人;每天同步证据和排除结果。若影响交付,我会把未闭环风险同步给项目负责人并提出隔离措施,找到根因后通过变更与回归测试结案。重点是让证据推动决策,而非让部门互相证明自己没问题。”
凡亿教育 · 电子工程师面试平台