 扫码关注



HardFault是很适合区分“写过代码”和“真正调过系统”的问题。面试官更在意你是否能从故障现场恢复出PC、LR、栈帧和Fault状态,再把问题缩到具体指令与内存访问。
面试先抓这几个点:
第一步先保留现场,不要让异常处理函数里再次破坏栈和关键寄存器。
Cortex-M异常入栈通常包含R0-R3、R12、LR、PC和xPSR,PC是回到故障指令的重要线索。
结合CFSR、HFSR、MMFAR、BFAR判断是非法地址、总线错误、未对齐还是执行错误。
最终要回到map/elf和反汇编,判断是野指针、栈溢出、越界、错误函数指针还是时序问题。
面试官真正想听什么
这类问题通常不是考一句标准答案,而是看你能不能把原理、工程约束、验证方法和风险连成一条完整链路。回答时建议先讲判断条件,再讲设计动作,最后补上如何验证。
回答时可以按这张表组织
| 现象 | 优先看什么 | 典型原因 |
|---|---|---|
| 访问异常 | CFSR、BFAR/MMFAR、故障PC | 空指针、越界、外设地址错误 |
| 随机跑飞 | LR、PC、栈边界、函数指针 | 栈溢出、内存踩踏 |
| 开优化才出错 | 反汇编、volatile、并发访问 | 未定义行为、竞态、错误优化假设 |
| 中断里触发 | 中断优先级、栈、共享资源 | ISR栈压力、不可重入函数 |
一个更像工程师的参考回答
我遇到HardFault会先保留现场,读取异常栈帧中的PC和LR,再看SCB里的CFSR、HFSR以及BFAR、MMFAR是否有效。拿到PC后用ELF或map文件定位到具体函数,再结合反汇编确认是哪条指令访问了哪个地址。如果是随机故障,我会继续查栈水位、数组边界、DMA写越界和函数指针。对于只在中断或高负载下出现的问题,还要检查中断优先级、共享资源以及栈是否足够。也就是说,我会从“故障寄存器→异常栈→代码地址→内存对象”逐级缩小,而不是重启后猜。
面试官可能继续追问
HardFault和BusFault、MemManage Fault是什么关系?
为什么PC定位到的指令不一定是根因发生的第一现场?
栈溢出为什么会表现成随机HardFault?
只有Release版本出现故障你会怎么排?
容易失分的回答
只说用J-Link看一下,不知道具体看哪些寄存器。
看到PC后就认定这一行代码一定是根因,不继续追内存破坏。
异常处理函数里打印太多,导致二次Fault。
面试前可以这样准备
熟悉Cortex-M异常自动压栈的基本寄存器。
准备一个野指针或栈溢出导致HardFault的调试案例。
练习从一个PC地址用map/elf定位到源代码。
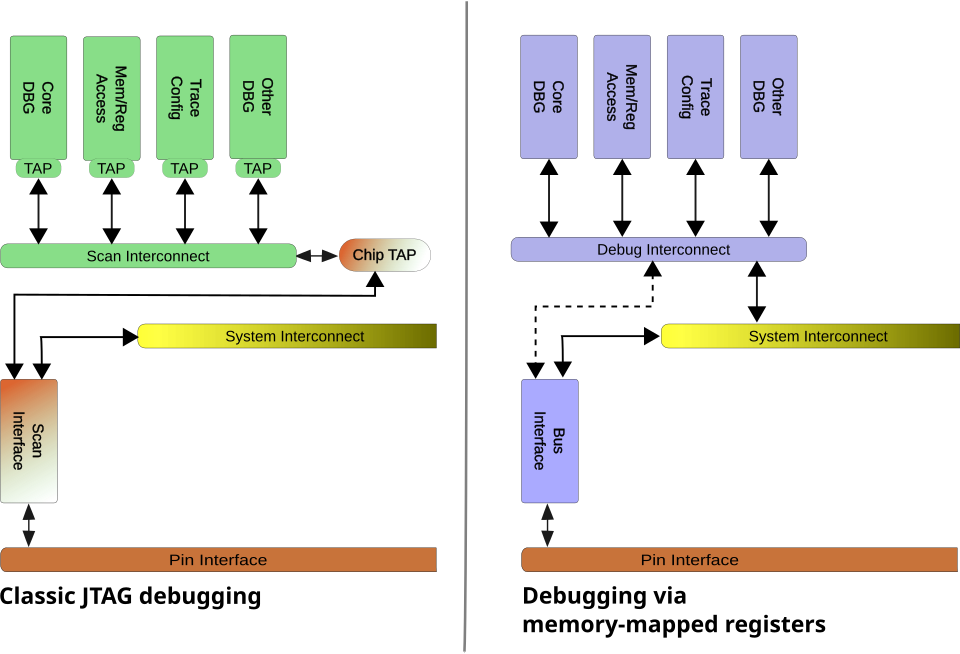
核心关键词:HardFault、Cortex-M、JTAG、SWD、单片机调试、嵌入式面试