 扫码关注



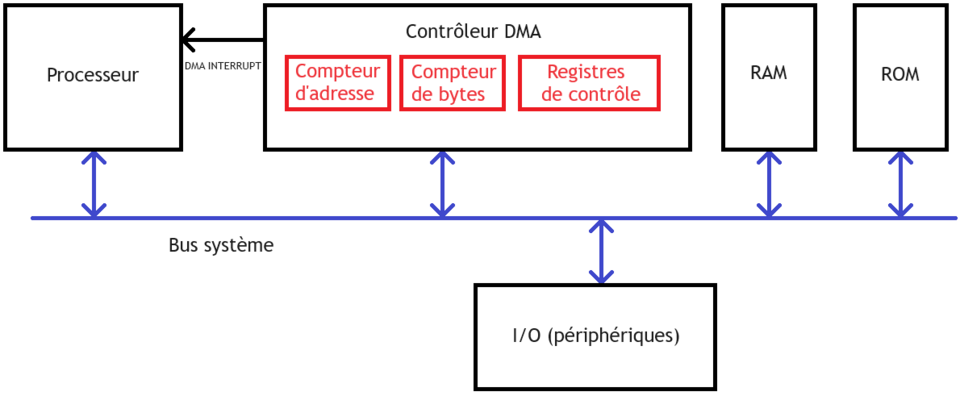
DMA能减少CPU搬运数据的负担,但“用了DMA”不等于不会丢数据。UART、ADC或SPI连续采集时,真正容易出问题的是缓冲区什么时候归DMA、什么时候归CPU,以及CPU处理速度是否始终跟得上输入速率。
排查/设计顺序
01
先算吞吐量
先算外设每秒产生多少字节/采样点,再看缓冲区大小能提供多少毫秒的处理窗口。
02
再定义缓冲区归属
DMA正在写的区域,CPU不要同时修改;CPU处理完成后,再把对应区域交回DMA。
03
利用Half/Full事件切片处理
循环DMA常用半传输和全传输事件,把一个buffer拆成两半,CPU处理上一半时DMA继续写下一半。
04
最后看最坏处理时间
平均处理速度够不够不重要,关键是最坏一次处理是否可能超过缓冲区提供的时间余量。
两个经常被忽略的点
常见丢数原因
中断优先级过低、业务任务阻塞太久、缓冲区太小、处理函数一次做太多工作,都会让DMA覆盖尚未处理的数据。
调试证据
给Half/Full中断打时间戳,记录写指针/读指针和丢帧计数,比“串口偶尔错几个字节”更容易定位。
面试参考回答
我会先算数据入口速率和缓冲区能提供的时间余量,再决定DMA buffer大小。循环模式下通常把缓冲区分段,用Half Transfer和Transfer Complete事件通知CPU处理已经完成的那一段,同时DMA继续写另外一段。关键是明确buffer ownership,避免CPU处理还没结束就被DMA覆盖。如果数据量很大,我会把中断里只做指针切换或事件通知,把真正的数据解析放到任务中,并监控最坏处理时间和overflow计数。
追问方向
DMA中断里为什么不建议直接做复杂协议解析?
双缓冲和单个循环缓冲有什么区别?
如果CPU平均处理速度快,但偶尔阻塞20 ms,还会不会丢数据?
带D-Cache的MCU使用DMA还要多考虑什么?
容易踩坑
认为DMA自动等于“零丢包”。
没有区分DMA正在写的区域和CPU正在处理的区域。
只看平均处理时间,不测最坏执行时间。
凡亿电子工程师面试平台 · 面试回答建议结合本人真实项目经历和具体器件/规范展开。